
Ken:解锁N8N之数据分析
方法论 · 覆盖 AI、方法论,约 5 分钟。
一、核心成果:
- 端到端无人工干预,闭环效率拉满
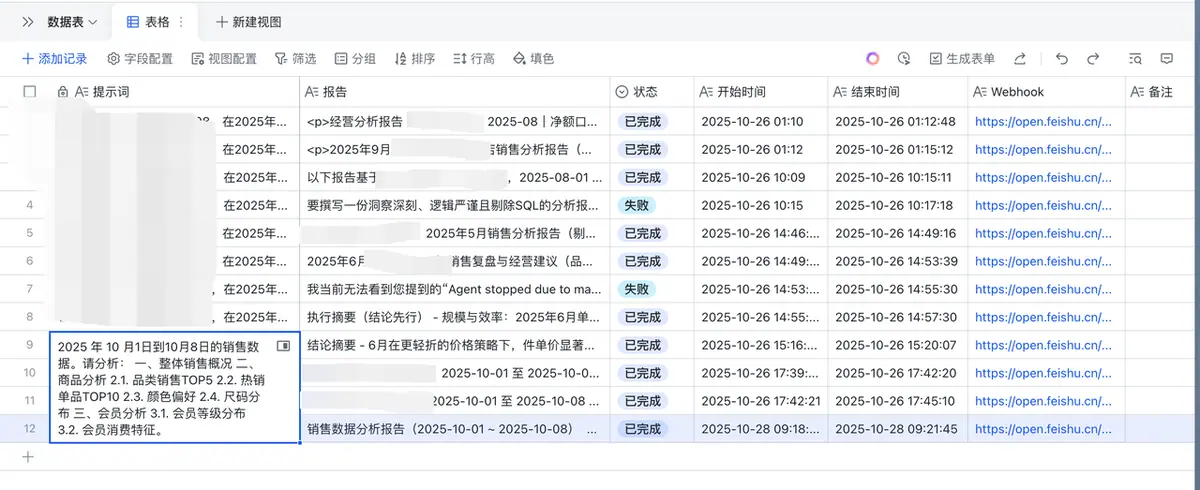
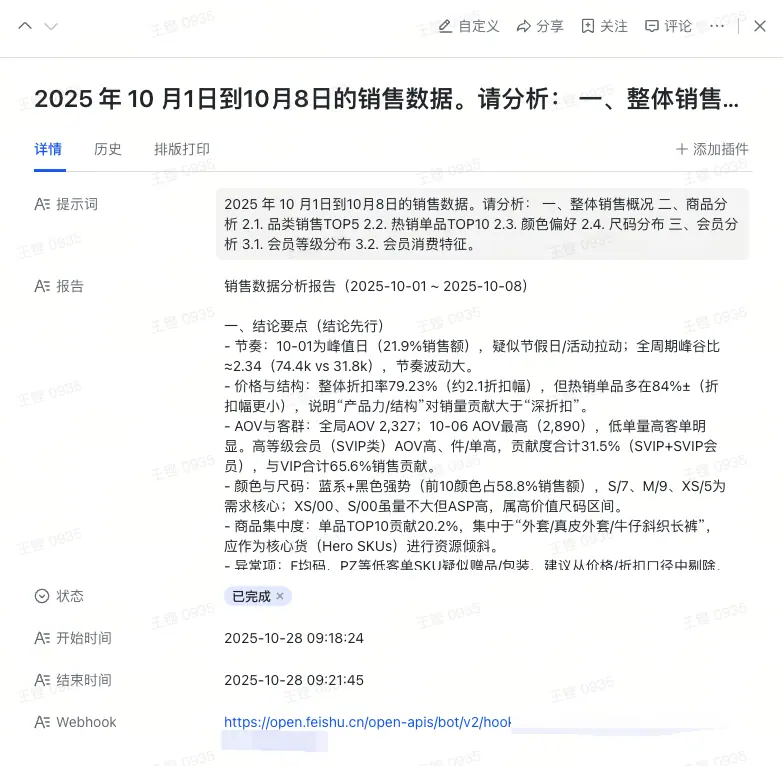
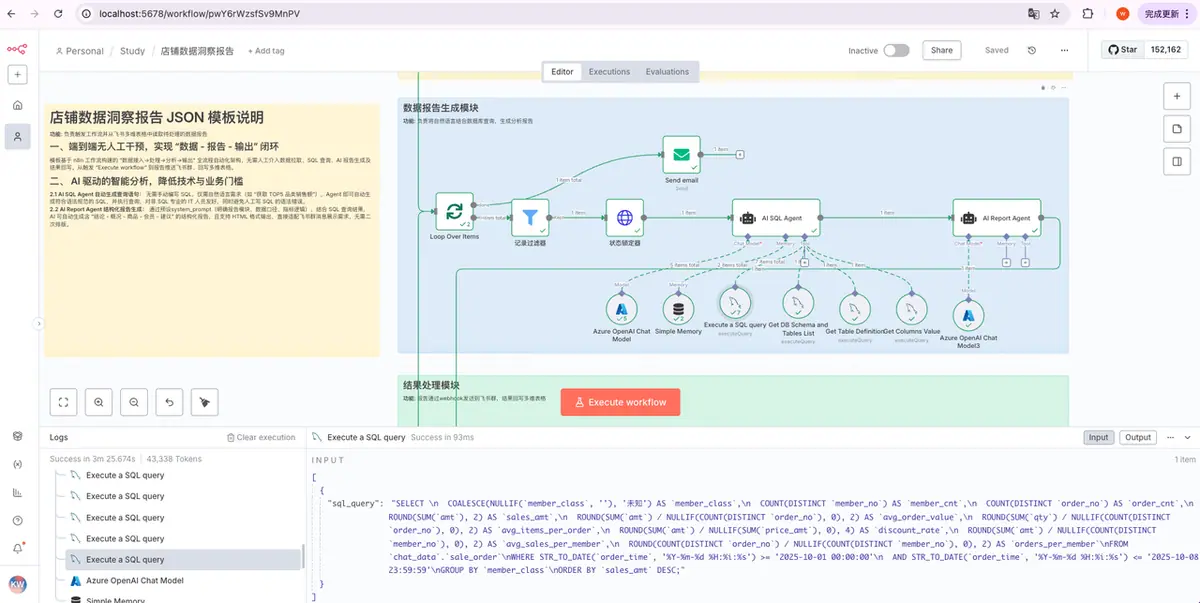
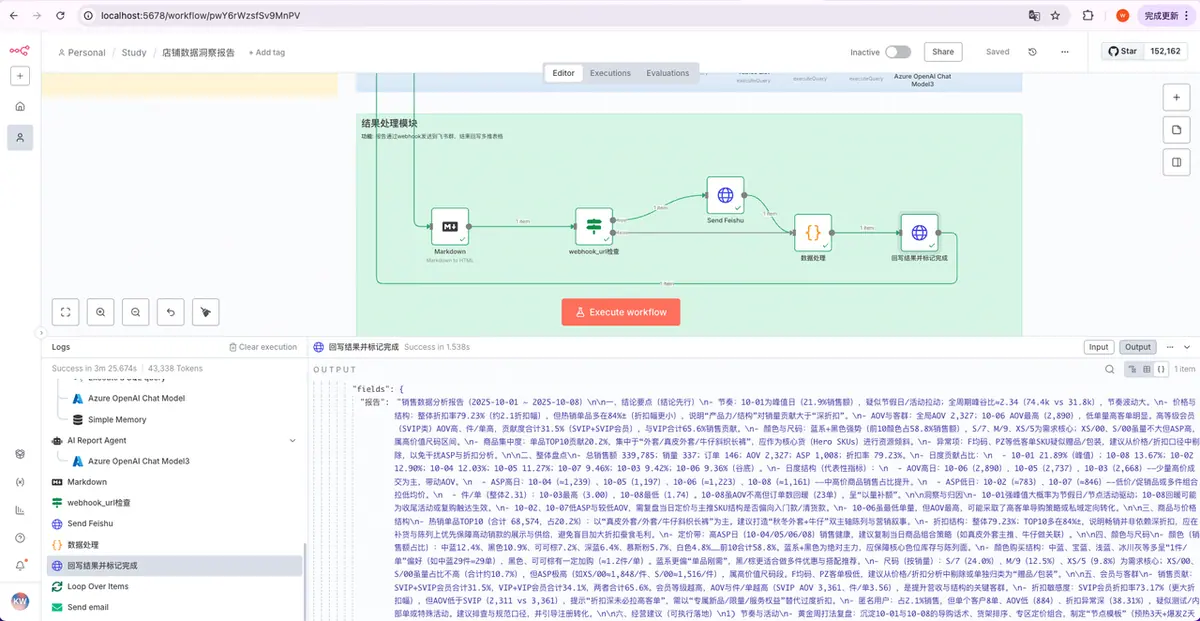
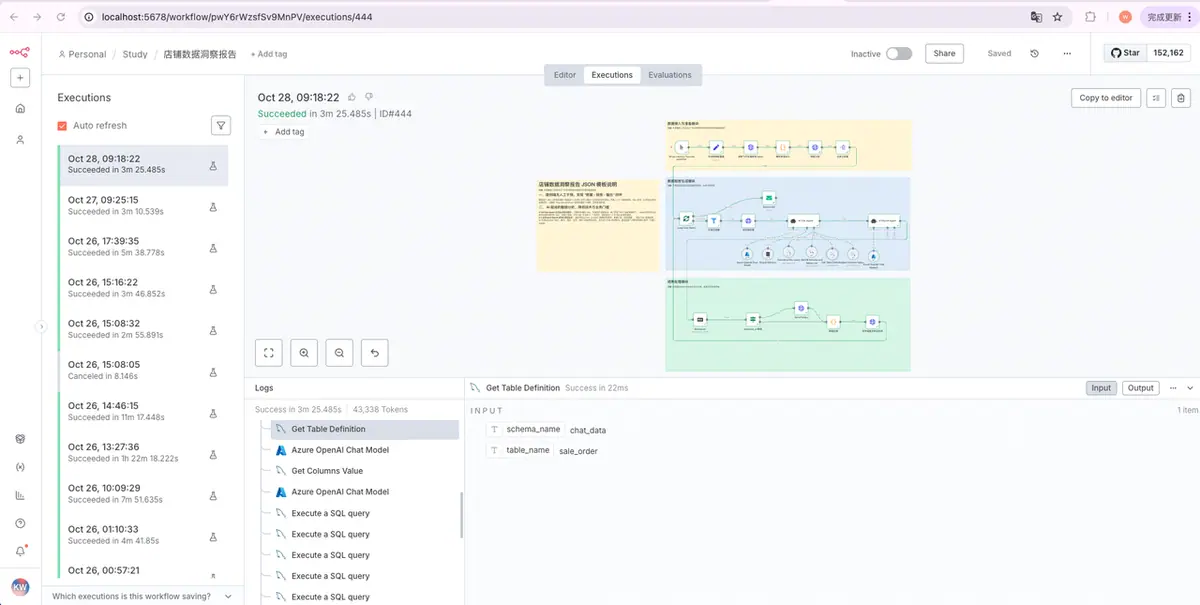
基于 n8n 工作流,我搭建了 “数据接入→处理→分析→输出” 的全流程自动化。从点击 “Execute workflow” 触发任务,到报告推送飞书群、回写多维表格,整个过程无需人工介入数据拉取、SQL 查询、AI 报告生成等操作,真正实现 “数据 - 报告 - 输出” 闭环,大幅节省时间成本。
- AI 驱动智能分析,降低双重门槛
- AI SQL Agent:自然语言自动转换SQL
无需手动编写 SQL 语句,只需输入自然语言需求(比如 “获取 TOP5 品类销售额”),AI SQL Agent 就能自动生成符合语法规范的 SQL 并执行查询。这不仅对非 SQL 专业的 IT 人员十分友好,还能有效避免人工写 SQL 时的语法错误。
- AI Report Agent:结构化报告自动生成
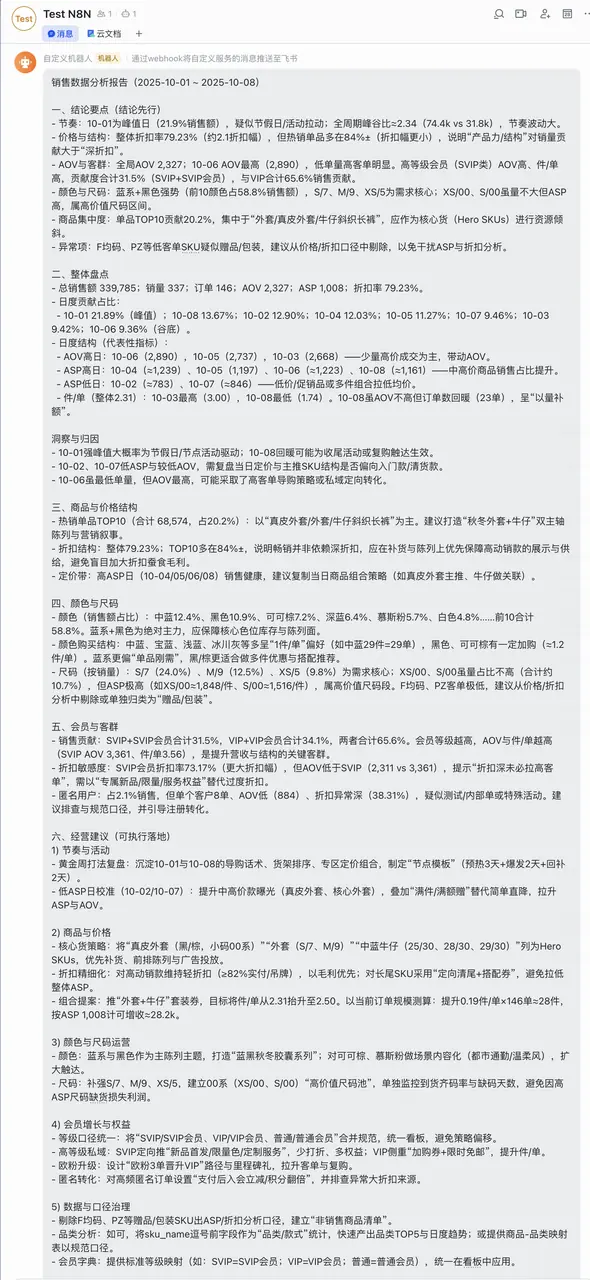
通过预设 prompt,结合 SQL 查询结果,AI 能自动生成包含 “结论 - 概况 - 商品 - 会员 - 建议” 的结构化报告。然后报告支持 HTML 格式输出,无需二次排版。
- 关键环节可视化(附截图提示)
多维表格
任务发起与结果回写的核心载体
N8N流程
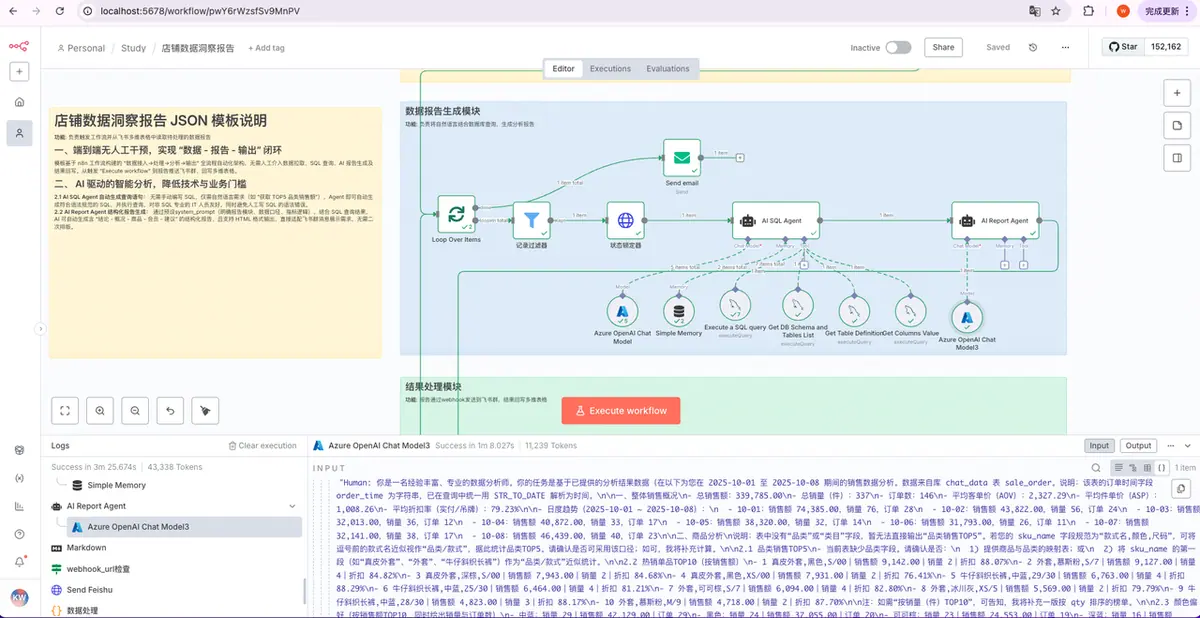
展示数据从接入到输出的每一步路径
飞书接收分析报告
涵盖核心结论与详细数据维度
二、构建难题:
在搭建 N8N 数据分析前,我曾尝试 Databricks 的 Genie、国内各类 ChatBI 等工具,但始终被两个问题困扰:
- 数据报告生成的矛盾
最初我设想直接将明细数据交给大模型生成报告,优势是大模型能挖掘出易被忽视的观点,但缺点也很明显 ——Token 数量有限,无法处理大量数据,最终还是需要先对数据进行汇总,效率大打折扣。
- 难以规避的数据幻觉
大模型在数据统计方面准确率极低,尤其是当输入数据达到一定量,大模型注意力分散后,数据幻觉现象会更明显。不过,GPT-5 的出现让我看到了改善的可能。
破局思路:复刻数据分析师工作流
为解决上述问题,我参考数据分析师的日常工作逻辑构建系统:先理解需求、拆解需求,再进行数据探查,接着编写 SQL、执行查询,最后结合数据与报告大纲撰写报告。
具体来说,我打造了 SQL Agent 和 Report Agent:SQL Agent 接收提示词后,调用获取表清单、表结构、字段值等操作进行数据探查,生成并执行 SQL,将数据传给 Report Agent;Report Agent 则结合数据与需求生成报告。
这种方式让 AI 既能发挥语义分析的优势,又避免了数据幻觉 —— 因为所有数据都来自 SQL 查询,而非大模型直接统计,兼顾了灵活性与准确性。
三、未来探索:
- 功能优化
- 报告展示:升级为图文并茂的 HTML 格式,更直观呈现数据洞察
- 数据处理:突破单表限制,实现多表关联分析,覆盖更复杂业务场景
- 业务适配:构建专属业务知识库,帮助系统理解业务黑话,提升分析精准度
- 场景范围延伸
将自动化数据分析场景从现有领域,拓展至 “人、货、场” 全链路,比如员工绩效分析、商品库存预警、门店客流洞察等,让数据价值覆盖更多业务环节。
四、本次收获:重新认识数据与 AI 的融合
此前总认为数据与 AI 关联性不强,或是落地应用成本过高。但通过这次用 N8N 构建自动化数据分析的实践,我真切感受到:数据与 AI 融合的时代已经来临。无需复杂技术架构,只要找对工具和方法,就能让 AI 为数据赋能,大幅提升业务效率 —— 这或许就是本次课题最有价值的启示。