
大模型+知识库/数据库问答实践过程的经验汇总
手册 · 覆盖 AI,约 25 分钟。
1 query 意图识别+意图补充+意图修复 环节
在之前【 悟乙己:想自己利用OpenAI做一个文档问答的话......】的一些文档问答里面,非常粗暴,query直接通过一些句向量去查询,实际应用中对精准度要求高的话,基本不奏效。
所以,这个环节就需要跟chatbot一样进行意图识别。
1.1 意图识别方式一:多关键词/主题词提取与检索
本篇【 小虫飞飞:LLM+Embedding构建问答系统的局限性及优化方案】的方案是
【关键词/主题词提取 + 基于多个关键词向量搜索】
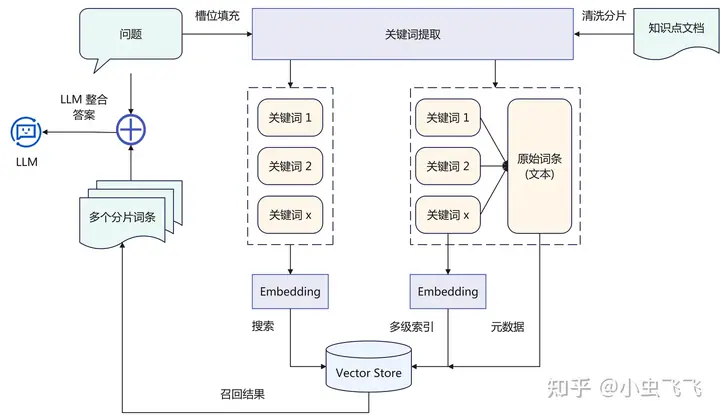
关键词/主题词提取:传统的 成分句法分析模型,具体方案如下:
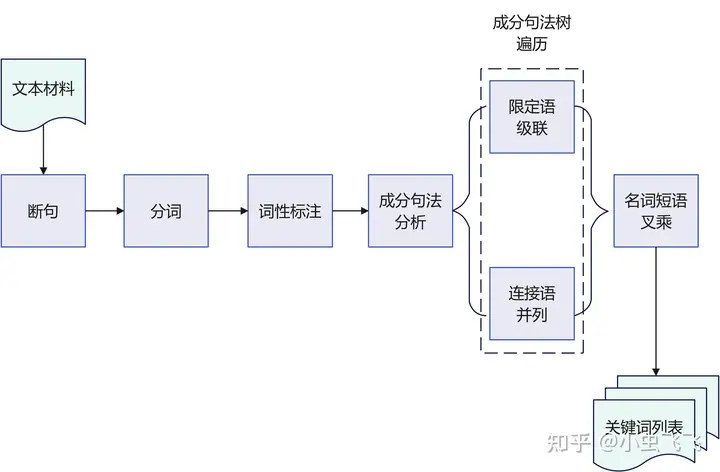
大致方案罗列:
- 基于传统 NLP 的成分句法分析,提取名词短语;再通过短语间的依存关系,生成关键词列表
- 从完整语句的 Embedding,切换为关键词 Embedding:
- 知识库构建时。基于单知识点入库,入库时提取关键词列表进行 Embedding,用于检索。
- 查询时。对用户的问题提取关键词列表进行 Embedding 后,从本地知识库命中多条记录。
- 将单问句中的多知识点拆解后检索,将召回的多条记录交付给 LLM 整合。
该方法的优势在于:
- 相比传统 Embedding,大幅提升召回精准度。
- 支持单次交互,对多知识点进行聚合处理。而不必让用户,手动分别查询单个知识点,然后让 LLM 对会话历史中的单个知识点进行汇总。
- 使用传统 NLP 在专项问题处理上,相比 LLM 提供更好的精度和性能。
- 减少了对 LLM 的交互频次;提升了交付给 LLM 的有效信息密度;大大提升问答系统的交互速度。
在北大团队发布法律大模型 ChatLaw中用到了以下
(参考: 北大团队发布法律大模型 ChatLaw,为大众提供普惠法律服务,将带来哪些影响?):
keyword LLM是一个微调的模型,来单独完成关键词抽取这个任务;
当然这里keyword LLM 从文章作者的说法来看,其实并不是大模型,是仿CLIP对比学习下的BERT模型,使用了94W全国判决文书而来。
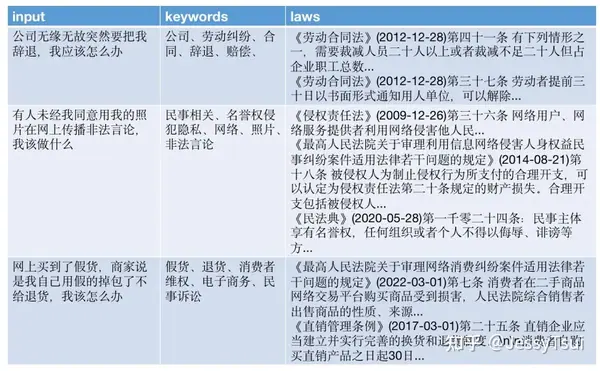
1.2 意图识别方式二:中心化大模型做语义识别
【 小虫飞飞:LLM+Embedding构建问答系统的局限性及优化方案】与【 小虫飞飞:基于大语言模型构建知识问答系统】
通过深度学习、统计学习,甚至 LLM ,理解用户问题提取语义槽中需要的内容。
在 基于大语言模型构建知识问答系统一文中给过例子:通过 System Role 告知LLM 需要提取槽位信息,让 LLM通过多轮对话引导用户给出所有槽位信息。
还是以游戏攻略为例,玩家咨询球员的打法,那么必须提供:球员姓名,年代(比如2020/2022 年),比赛模式。对应的语义槽可以定义为:
1.3 意图补充、修复、改写
从【 【text2sql】基于ChatGPT打造'中文自动转SQL'产品(第一部分)】贴一些,从聊天机器人侧,query还需要做的一些功能点:
- 引导能力,槽位补充能力
- 用户:我想查一下电量;Bot: 好的,请问您想查的时间范围、空间范围,和分项是?用户:查上个月的整个园区的吧;Bot:好的,那请问是要查照明、空调、动力的还是其他类型的耗电量?用户:就查询各个分项的,和总体的都查询。Bot:好的,那我复述一下,您希望查询,"照明、空调、动力的还是其他类型的耗电量,以及总体耗电量,时间范围是上个月,空间范围是整体园区",请问是吗?用户:是的/没问题/对。
- 引导用户表述完整,查询要素,指标、维度、范围
- 槽位修复能力
- 比如:“好的,查询目标设置为查询温度,请问查询哪个空间的温度?”
- 指代消除,解析能力
- 澄清,它、这等指代词的具体含义
- 改写
- 改写模块其实非常关键,数据库的存储有特定的形式,但是用户不会按照你的底层数据结构去写,例如,用户不见得会输入和平精英,而是吃鸡,数据库里可不见得会存吃鸡对吧
从【 小虫飞飞:基于大语言模型构建知识问答系统】类似与将chatgpt变成一个NPC进行对话,用来回收+修复槽位
改写模块包括(来自【 R&S[21] | 搜索中涉及的算法问题 】):
- 同义词改写。上面的吃鸡就要改写为和平精英,这个需要通过同义词挖掘等方式去构造词典实现。
拼音改写。数据库是罗密欧与朱丽叶,但是用户输入的是罗密欧与朱莉业,拼音改写其实颇为常见,用户经常由于找不到需要的结果或者不知道应该需要哪个,于是直接输入后开始搜索。
前缀补全。非常常见,用户输入射雕,射雕英雄传就要出了,这个一般的方法也是构造词典,另外有一个很重要的需要了解的就是前缀树,这个能让你查询的时间非常低的水平(只和query长度本身有关)。
丢词和留词。结合上述关键词提取和命名实体识别完成,有些不必要的词汇需要被删除,例如“李小璐到底怎么了”,整个句子只有李小璐是关键词,其他词如果也通过and逻辑召回,就没有信息召回了,这时候其实可以直接删除或者将降级到or逻辑。留词和丢词相反,丢词如果是做减法,留词就是做加法。
近义词召回。这个召回不是从数据库中召回,而是召回近义词,具体的方法是通过embedding方法转化词汇,然后通过ball tree、simhash的方式召回与之意思相近的词汇,该模式虽然比较激进,但是能一定程度增加召回,有一定效果。
1.4 多轮对话意图继承能力
- 意图继承能力
- 多轮对话之间的意图继承
而多轮的根本难题在于,如何把关键信息保留并在合适的时间取出并使用。目前的大家可能用的比较多的是直接拼接历史对话,这点并非不好,凭借大模型的能力确实能做到很高程度的多轮对话,但实际上,我们还是可以用很多思路(来自: 提升大模型系统体验的一些思路):
- 简单的,可能并不需要考虑模型回复的内容,只需要拼接用户query。
- 单独构造DM模块,结合NER做槽位继承。
- 参考科研界的一些做法,做更加抽象的矩阵DM,然后配合大模型计算。
1.5 过长提问的总结
- 过长提问的总结
- 比较长的提问可以通过LLM进行归纳与总结
1.6 拒绝回复
来自【 提升大模型系统体验的一些思路】
拒绝回复其实很多场景会应用到,例如在面对用户提问的内容并不是目前我们预期支持的领域(客服场景问天气),或者用户所问出现观点类(如何看待俄乌问题)、黄反类问题(这个就不用我举例了吧)、大模型安全(query中带有诱导性错误)时,再就是知识库为空的情况,我们就需要进行拒绝,并给用户一些回复,让用户不至于那么不舒服。常见的策略一般有这些:
- 一句写死的回复:“哎呀,这方面的问题我还不太懂,需要学习下”。
- 用大模型生成,例如借助prompt引导生成一些安抚性的回复,“对不起,你问的[]问题,我好像还不太懂。你可以试试问问别的”。
- 使用推荐问或者追问的策略。(你是否在找以下几个问题XX;你描述的我好像不太懂,能再补充补充吗)
其实也可以看到,也不见得非得用大模型,有时候写死或者做一些推荐问疑似问( 前沿重器[12] | 美团搜索引导技术启示 ),好像也可以。
2 Text-to-SQL 环节
2.1 通过优质大模型解决 Text-to-SQL 的精准度问题
具体的任务如下:
当前LLM处理这个任务时,有两个大的难点:
- LLM当前不具备6张表关联如此复杂的SQL编写能力。
- 受限与Token长度,我们无法直接将所有的表信息提供给模型来生成正确的SQL语句。 基于大模型当前的能力,我们通过系统架构优化的方式,对此问题进行了解决, 首先我们看看整体的架构图。
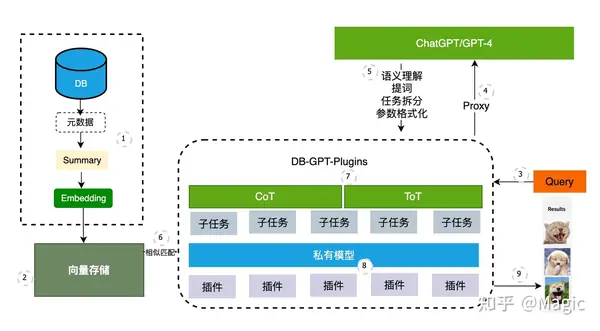
Text-to-SQL 的一个解法:【大模型帮助小模型】
大帮小其实指的是大模型帮小模型,更具体一点。就是通过ChatGPT/GPT-4、通义千文,文心一言这样更大的模型,来辅助私有化部署的百亿级模型来完成任务。 在我们写SQL这个案例当中,一个关联6张表的查询小模型是非常难理解的,因此我们会根据Query + Summary的内容让大模型先完成语义提取。 将复杂问题的理解,格式化输出一个固定的ToT的模版内容,将复杂的任务拆解为几个独立的简单步骤。
在此之后,我们将每个小步的任务丢给小模型去处理。 当然在这个环节,我们为了更稳定的效果,还需要跟大模型完成一些交互。 比如在DB-GPT当中,我们发现Vicuna-13b在格式化输出Json时,准确率跟稳定性都比较差,正确率不到70%,这需要我们编写大量的代码来处理格式。以如下格式为例,但当我们调用GPT-4来格式化时,准确率跟稳定性能达到95%以上。
因为是一个多步拆分任务,所以模型执行的中间结果,我们会暂存在一个中间态。 最后在通过链式计算来返回最终正确的结果。
构造 prompt:
- 指令 —— 希望模型输出 SQL
- 上下文 —— 当前在哪个库,哪个表
- 输入数据 —— 表结构 - DDL
- 输出指示符 —— 我希望输出纯正 sql,不想解析一堆内容
于是我们就有如下构造方式
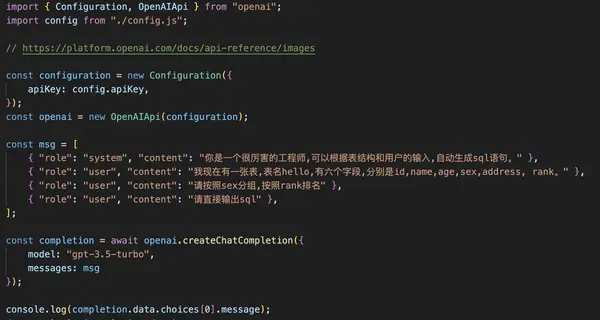
其思路就是把表结构和用户输入传给 GPT 由 GPT 去编写。我们目前的可能产品形态如下:
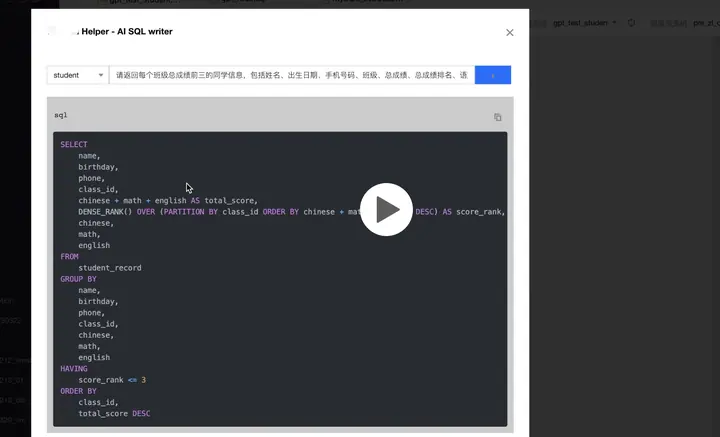
用户输入复杂的描述,其中甚至带有很多对 SQL 语法的要求,GPT 也能快速准确的返回。
2.2 对Text-to-SQL 任务拆解
源自: 平凡的程序猿:LLM在中文Text2SQL任务上的优化V1.0以及 平凡的程序猿:LLM在中文Text2SQL的实践
Text2SQL的子任务拆成3个子任务:
- Schema Link :第一是利用LLM对用户的输入进行语义理解,然后结合数据库中表的结构信息,抽取出相关的字段信息
- Task Classification:任务分类
- Sql Generation:利用抽取的字段信息生成结构化的SQL语句
此时设定的prompt结构是:
Instruction表示大模型需要执行的指令,Context表示的是上下文信息,Input Data 表示的是需要处理的数据,Data Indicator表示输出信息格式的指引。
其中:
prompt 的case可参考:【 平凡的程序猿:LLM在中文Text2SQL的实践】 以及【 京东云:LLM 在 text2sql 上的应用 | 京东云技术团队】
其中在做Schema Link 时候,可能会因为项目大,完成prompt比较麻烦,也可以使用COT Prompt,可参考: 平凡的程序猿:LLM在中文Text2SQL任务上的优化V1.0,包括:
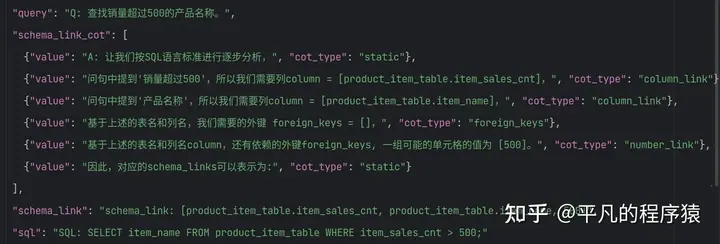
其中:
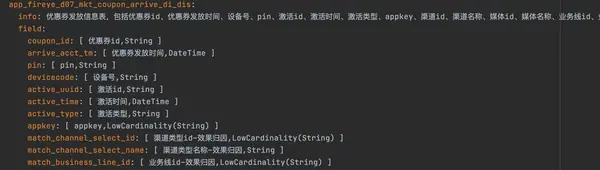
数据表的 schema 设计非常重要,需要描述清楚这个表它的主体信息以及表中重要字段和字段含义。
2.3 SQL 修复
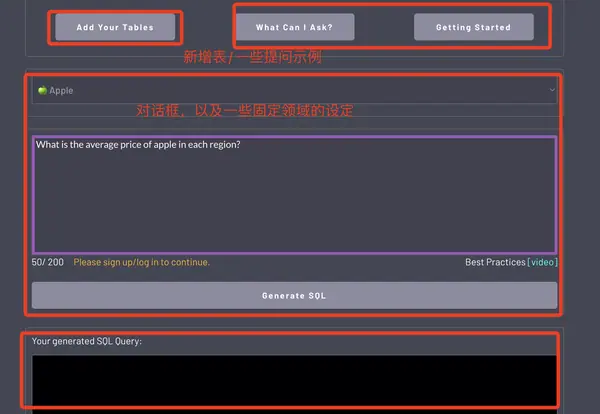
同时,类似AI2SQL的产品【 SQL query builder - SQL query builder AI bot】,也有SQL的修复模块
功能包括:
- 格式SQL代码
- SQL语法检查和修复程序
3 知识库的向量搜索
本篇不做过多累述,详情看: