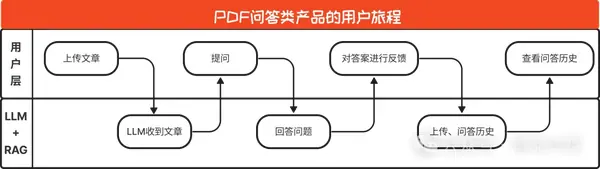
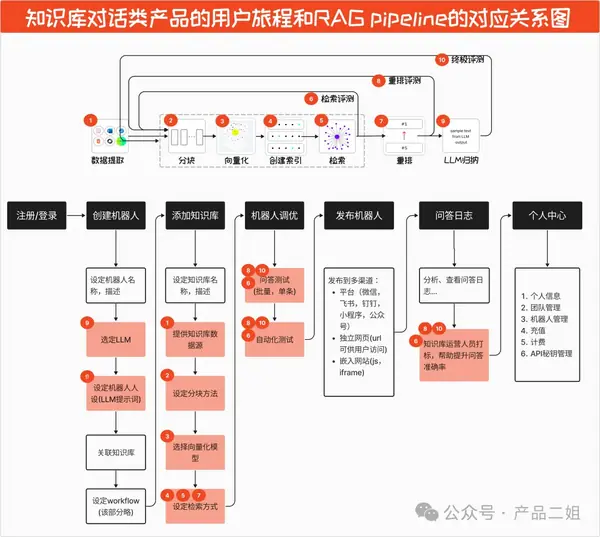
大模型+知识库/数据库问答实践过程的经验汇总· 第 2 / 2 页
4 结果核验与总结
在【 如何用大语言模型构建一个知识问答系统】结果整合的主要作用是将本地搜索系统返回的结果进行二次加工,比如发挥 LLM 的:
- 结果检验
- 总结、概括
- 格式整理
- 去重、翻译
- 从会话历史中,提取上下文,进行分析处理等能力
4.1 结果总结
召回的信息可以通过大模型可以用来做summary以及结果的核验。在【 唔讲粗口:一文了解:打造垂域的大模型应用ChatGPT】使用了思维链进行反复推理,来生成最终正确的结果。
在私有化模型下,反复推理的成本跟模型稳定性,目前表现还不那么令人满意,为了节约成本增加稳定性,我们在ToT环节里面,加入了ChatGPT/GPT-4来做正确性论证的能力。
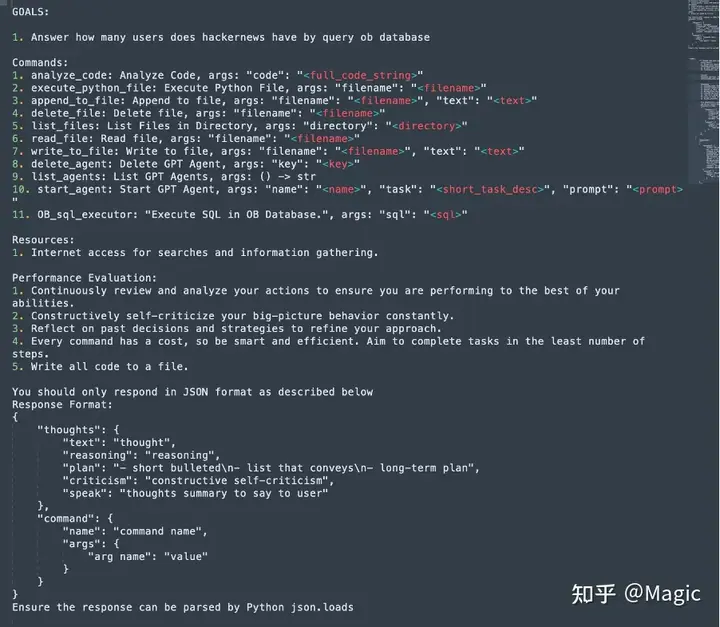
以上即为我们综合考虑成本、隐私、效果制定的一个折中方案。 核心数据资产通过本地化Embedding模型,Summary之后存储在私有向量数据中。 用户复杂的问题通过DB-GPT Proxy转接给中心化大模型做语义识别与任务拆解。 拆解完成的小任务,通过DB-GPT中的私有化大模型完成具体的任务执行。 最后结果通过思维链/思维树的路径进行多轮验证来确保得到准确的结果。 在这个过程中,用户数据与跟用户环境交互的模型都是本地化的。但是在任务拆解、格式化输出等方面,我们为了提供准确率同时降低推理成本,将这部分任务拆解给了ChatGPT/GPT-4这样的API来完成。
4.2 毒性检验
LLM 会努力让其回答符合人类的价值观,这一工作在模型训练中叫做“对齐”(Align),让 LLM 拒绝回答仇恨、暴力相关的问题。如果 LLM 未按照设定回答了仇恨、暴力相关问题,我们就称之为检测出了毒性(Toxicity)。
对于我们即将创造的机器人,其毒性的范围实际上增加了,即,所有回答了非公司业务的内容都可以称之为存在毒性。
需要使用 Few-Shot 的方法去构建毒性检测的提示词,让 LLM 在拥有多个示例的情况下,判断用户的提问是否符合企业服务的范围。
4.3 输出结构对齐
这种情况非常多,而且不论是什么大模型都会遇到这种情况:
此时多了一个 SQL ,需要做修剪
此时解决方式:
- 优化prompt查询,更加专业的instruction,给出具体范例让LLM做参考
- 输出的内容做一些正则
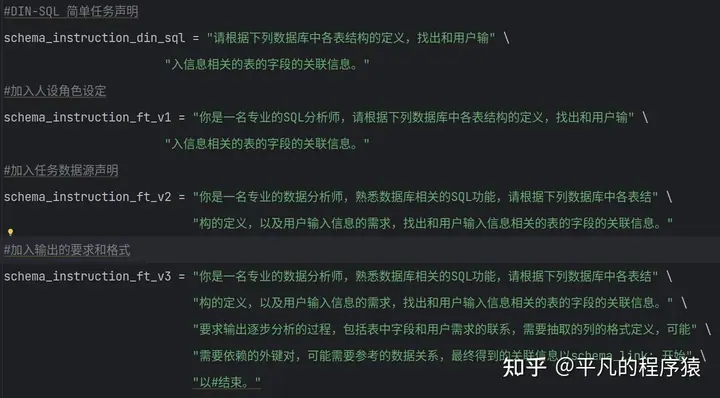
4.4 Text2SQL 数字幻觉
有可能出现数字幻觉,比如输入是: 点击率大于8% ,最后生成的SQL语句则是: 8 ,来自: 平凡的程序猿:LLM在中文Text2SQL任务上的优化V1.0
此时可在prompt中提及:
5 产品/数据的持续运营
为了让 TiDB Bot 的优化能够持续进行,我们搭建了一个内部运营平台,该平台能够较为便利的实现本文介绍的几种优化方法。该平台的核心能力有:
- 反馈信息展示:展示用户对回复的点赞或点踩。针对点踩的信息,展示信息流上每一个节点的处理日志,方便进行问题排查。
- 示例快速补充:针对每一个与 LLM 交互的节点,都支持提供示例的能力,包括修订问题,毒性检测,领域知识,等所有环节,都能够快速补充示例。
- 领域知识自动更新:对于有固定来源的领域知识,如 官方文档,支持定时自动更新向量数据库中的文档内容,保持领域知识始终最新。
- 模型迭代数据整理:自动整理 Embedding 模型微调所需的训练数据,包含用户的点赞信息和运营时补充的示例信息等。
持续人工运营的优缺点:
- 优点:
- 相对稳定的正向优化。本文采用了系统的方法去优化准确率,而不依赖模型训练产出的随机性。
- 快速。示例部分的优化可以达到分钟级别的迭代速度,如果用户在使用过程中遇到问题,可以尽快修复。
- 便宜。仅需要复用已有的语义搜索能力,不需要额外的组件,不额外支出成本。
- 迁移成本低。本文的方法在任何 Chat 类型的 LLM 模型都可用,因此可以快速迁移到其他模型上。如果开源或商业模型中有更好的模型,我们可以尽快接入。
- 冷启动友好。遇到问题解决问题,不需要事先准备庞大的训练数据。
- 缺点:
- 需要更高频的人工介入。因为示例的方法需要更多的人工审核和补充过程,在产品运营过程中需要比模型微调更高频的人工介入频率。
- 内容数量过多。在运营一段时间后,补充的内容可能过多,导致难以维护,和搜索准确性的下降。
6 云厂商的集成方案
6.1 基于Azure OpenAI模型服务的知识库问答系统
在文章【 唔讲粗口:一文了解:打造垂域的大模型应用ChatGPT】提及到的Azure
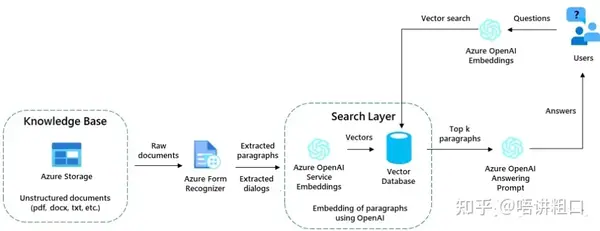
这个demo搭建了一个简单的基于OpenAI的知识库问答系统,企业可以将内部的各类文档、表格、图片等转化为方便模型计算的语义向量,存入向量数据库中。当用户提出问题时,它从知识库(向量库)中检索匹配出最相关的文档,然后使用GPT来生成问题的最终答案。
不过具体实践中应该还是会有很多问题
6.2 阿里云的 Tair向量检索
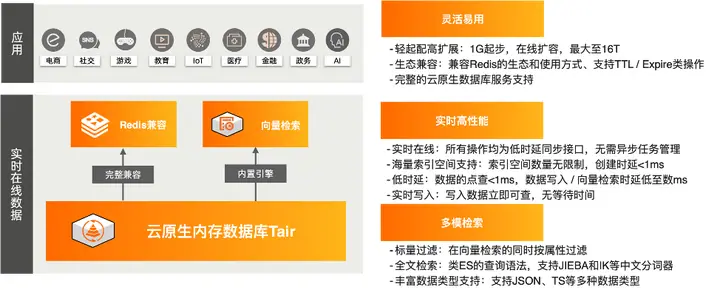
具体没有测试过
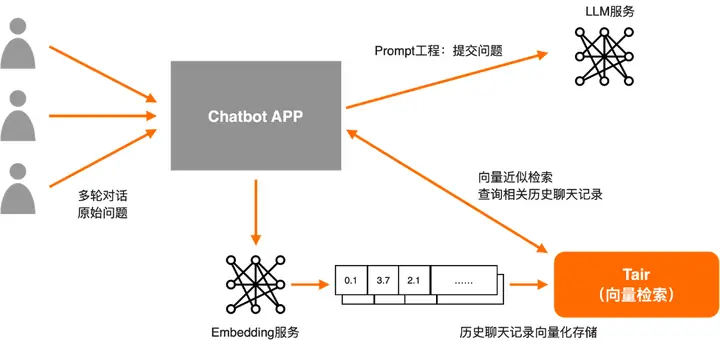
以ChatGLM为例,将用户的历史记录作为请求的一部分持续追加,当超过Token数限制的时候就需要丢弃老的聊天记录,因此LLM方案无法实现太长的多轮对话能力。而基于Tair,可以将用户的历史聊天记录存在Session中,这些信息可以设置TTL等过期机制,并且Tair也支持海量的索引空间(Session)。在请求LLM的时候,通过向量检索技术,将相关的历史信息检索出来,通过Prompt润色后,一并发送给大模型,可实现基于多轮对话下,长期的上下文感知能力。
6.3 AquilaSQL-7B 文本-代码”生成模型
AquilaSQL在代码基础模型AquilaCode上进行继续预训练和sft微调,为模型设计了指标评估体系,目前在cspider榜单上达到了sota,可以通过更改数据的方式适配不同领域的sql查询场景。
训练示例:
6.4 我在调研了十几个知识库对话产品后整理出来的功能清单
RAG+LLM 的 AI 应用是目前为止对于独立开发者来说最易实现的 AI Native 应用,毕竟市场上已经有很多的榜样去学习了,比如:
- Perplexity: 将搜索结果中的内容作为 RAG 资料库生成答案。
- OpenAI 的 GPTs:将用户上传的资料作为 RAG 资料库生成答案。
- 各种 PDF 读论文工具:将论文作为 RAG 资料库生成答案。
- 垂直领域诸如法律中的合同审查:将合同作为 RAG 资料库来核实合同