大模型数据分析实例拆解
手册 · 覆盖 私域、AI,约 12 分钟。
前言:
我教体系化的提示词课程有大半年了,随之而来的是数据管理和分析的挑战——如何从这些数据中获得真正有价值的洞察,不断优化课程 → 如何有效盯作业和课程进度。
随着课程参与度的提高,我手中积累了大量数据。本来期望通过这些数据能够清晰地看到学习习惯和进度卡点,找到改进方向。但我现在用的课程平台呈现出的数据结果既混乱又难以解读。
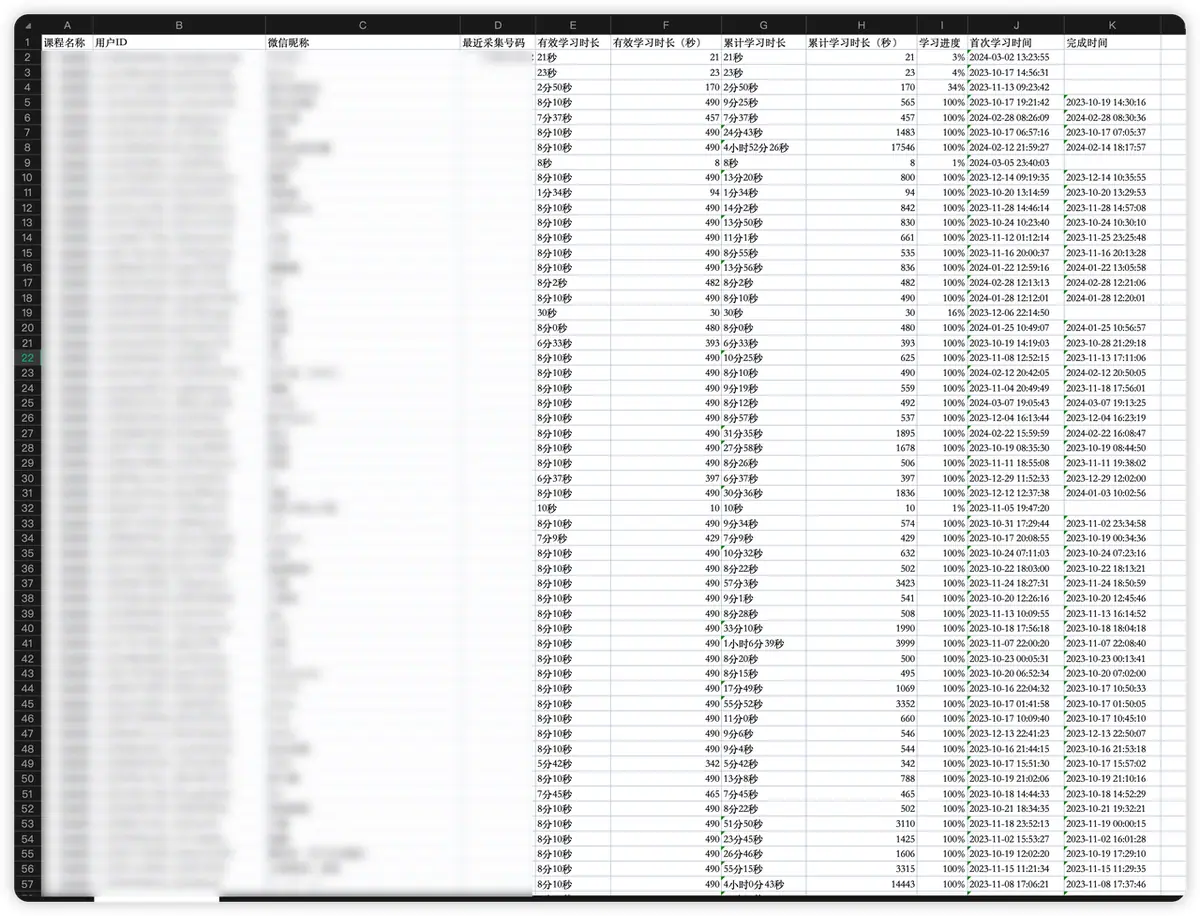
上万条海量的课程数据
| 亟需一个能够帮我整理这堆乱麻、让数据变得清晰、有序,甚至能自动给出建议的工具! |
|---|
我用大模型做了:自动化处理繁杂的数据→编写分析指令→深入分析→图形化展示结果
分享一下我的实践和用到的 Prompt,为同样面临这类挑战的朋友提供一些思路和工具:
一、 数据预处理
数据基本情况
小七姐使用的课程管理平台所涉及的课程数据分散存储在多个地方,这其中包括学员信息、课程详情、以及具体的单节课程数据等。由于涉及的学员人数众多,同时课时数量庞大,导致生成的数据既庞杂又混乱。最初,在课程启动时,对于信息的整理和统计工作并未给予足够重视,这也使得系统中大量存在无效或重复的数据冗余问题。
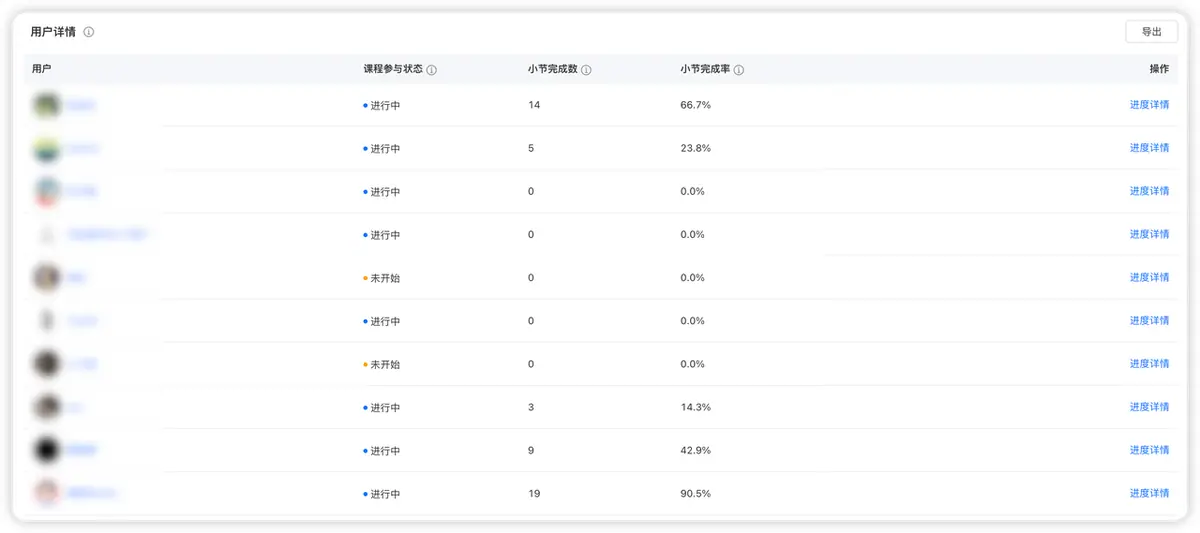 课程总列表 |
单课数据列表 |
|---|
学员列表 |
单课学习情况列表 |
|---|
数据清洗
由于涉及到的工程量比较大,这里我选定了一个方向进行尝试:统计每课的完播率和复播率,并筛选选出学习进度低于50%的学员,以便后续进行回访。
确定了方向以后,先下载每节课数据:
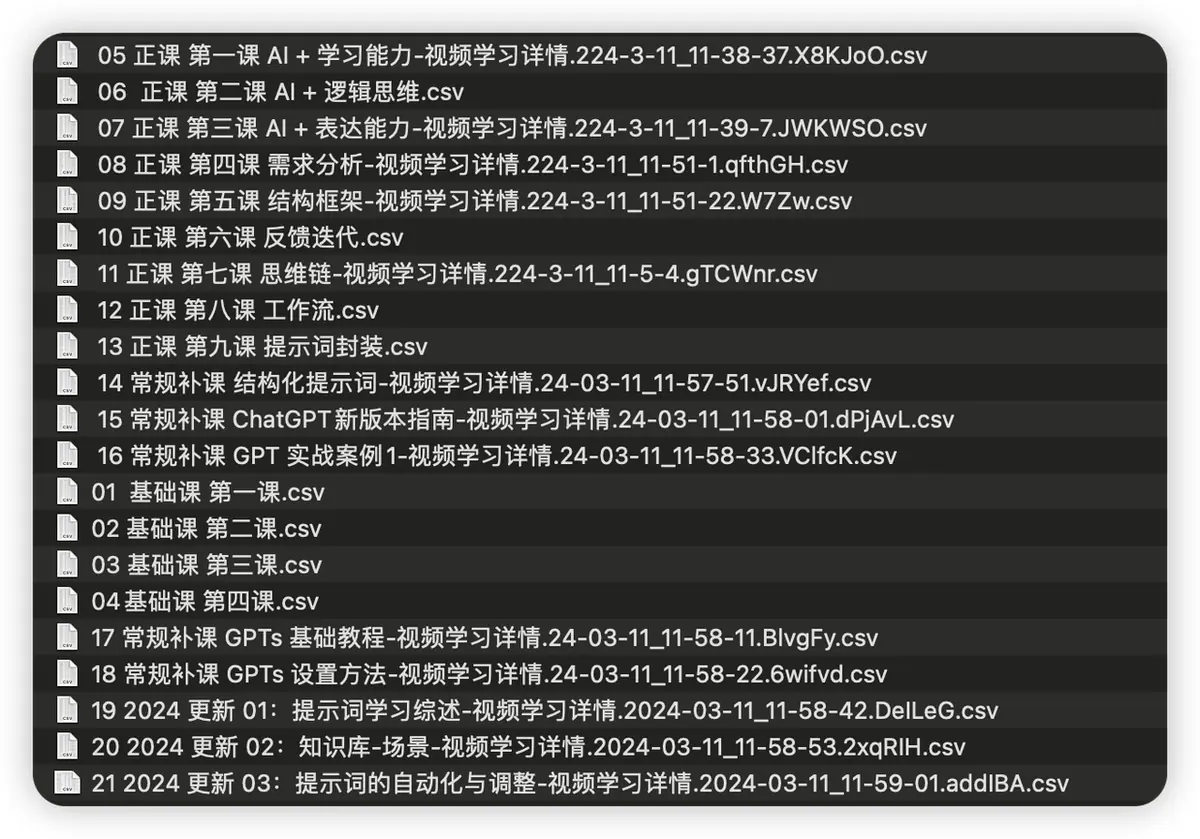
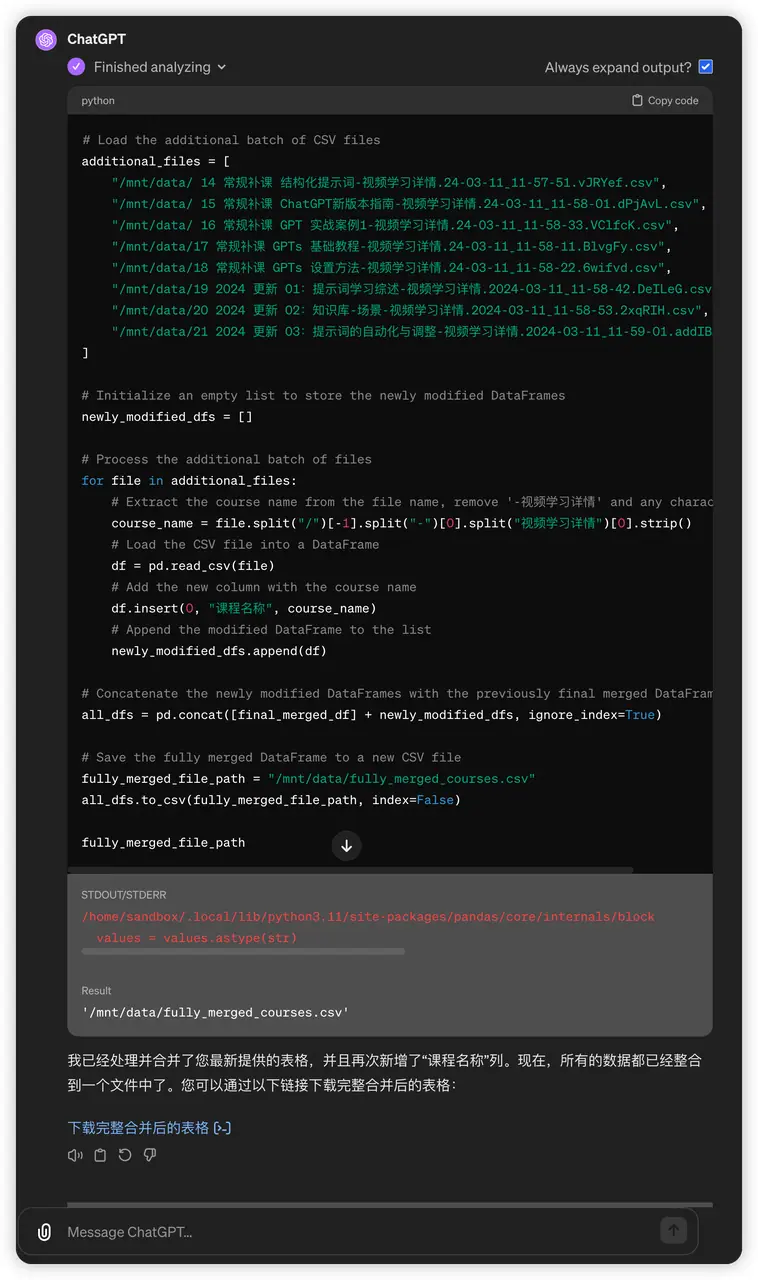
由于课程多,在试验了几次一起上传给 GPT 的做法失败后,我想到了把所有表格合并在一个表格的想法。
于是有了第一个提示词:
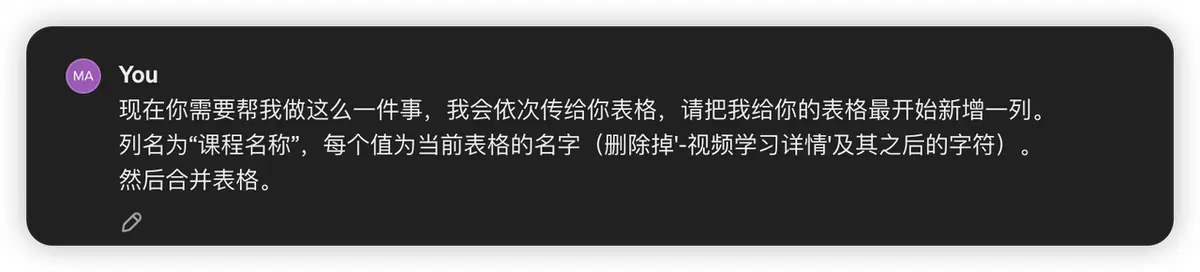
| 这步操作起到两个作用: 整理并规范课程名称; 合并所有列表以便后续操作。 |
|---|
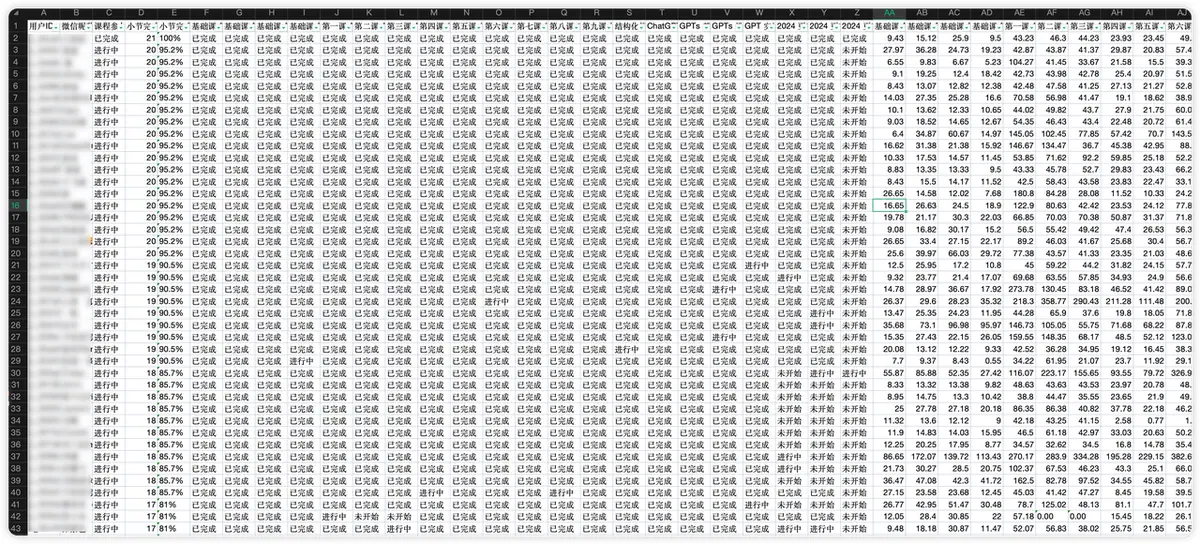
最后的处理结果如下,总计16845条数据: