观点 · 大模型与超级智能· 第 2 / 5 页
1.4 AGI元年(2024)
OpenAI在2024年初推出了文本到视频生成模型Sora,这应该是目前最好的视频生成模型。Sora能够生成一分钟的高精度视频。更重要的是,这让大家看到也许这是构建物理世界通用模型的可能路径。Sora的主要技术思路是用视觉块编码(Visual Patch)的方式,把不同格式的视频进行统一编码,然后用Transformer架构进行训练,并引入类似Diffusion的Unet方式在降维和升维的过程中做加噪和去噪。Sora技术报告提到是一个Diffusion Transformer架构,但笔者团队曾经测试发现该架构与Unet相比有一定差距,因此OpenAI可能在这方面做了较大的改进。此外,OpenAI极有可能在2024年推出下一代模型GPT-5,也许会有全新的代号,无论如何比较肯定的是其认知能力将带来通用人工智能的再一次变革。其下一代模型在技术上可能解决目前ChatGPT中存在的事实性以及推理能力的缺陷,实现更精细的语义理解、多模态(文本、图像、语音、视频等)输入和输出,具备更强的个性化能力。此外人工智能的发展会更多瞄向通用人工智能,实现AI的自我解释、自我评测和自我监督,构建超过人类水平的超级认知智能(super intelligence),并且确保模型的表现符合人类的价值观和安全标准。2023年7月,OpenAI公布了由其首席科学家伊利亚·苏茨克维(Ilya Sutskever)和首席强化学习专家詹·雷克(Jan Leike)发起的超级对齐计划(Superalignment),目标就是实现机器自动对齐人类智能和人类价值观,实现模型的自我反思和自我监控。相信在2024年会有更多研究者加入到通用人工智能和超级认知智能的研究中。
二、GLM-4
大模型经过预训练后可以获得语言生成、世界知识、上下文学习(in-context learning)、代码理解/生成、复杂推理/思维链等能力。OpenAI的GPT系列模型历经三个主要阶段,形成了目前ChatGPT的对话能力。第一个阶段是2018~2020年,OpenAI每年发布一个基座模型版本,直到2020年的千亿基座模型GPT-3,其基础的语言生成能力和零样本泛化能力大大增强。第二个阶段是指令微调,旨在提升模型在各项任务上的泛化能力,要求指令种类足够多,每种指令的例子也要足够多。指令的指数级增长会带来跨域迁移能力的线性增长。单个指令下实例数的指数级增长也会带来该指令能力的线性增长,但也可能使其他指令的能力弱化,因此组合泛化能力尤为重要。例如,给定的指令同时包含摘要、问答、生成代码的指令,模型可以自动将这三项能力混合在一起,同时完成问答、摘要生成、代码生成的任务。可以将指令视为线性代数中的一组基,将不同能力混合在一起实际上就是对线性空间中的基做线性组合或凸组合。模型在没有见过指令时,只能在学到的空间内做插值,而很难外推到没有学习到的基上。第三个阶段是人类反馈的强化学习,这是根据用户反馈通过强化学习优化模型输出。在ChatGPT之后,OpenAI又增强了GPT-4的多模态能力,并通过增强智能体(agent)能力实现了应用商店GPTs。
笔者团队在2020年提出GLM算法框架,从那时起,我们就希望GLM能成为与OpenAI的GPT对标的技术体系。2022年我们发布了GLM-130B千亿基座模型,2023年连续发布了三个对话模型ChatGLM、ChatGLM2、ChatGLM3。2024年1月16日,我们公布了最新的GLM-4,将基座模型和对话模型统一了起来。相比ChatGLM3,GLM-4的性能大大提升,接近GPT-4;支持更长上下文(128 K);支持更强的多模态能力;支持更快的推理速度、更多的并发,大大降低推理成本;同时GLM-4增强了智能体能力。图1展示了GPT系列模型和GLM系列模型的演进历史。
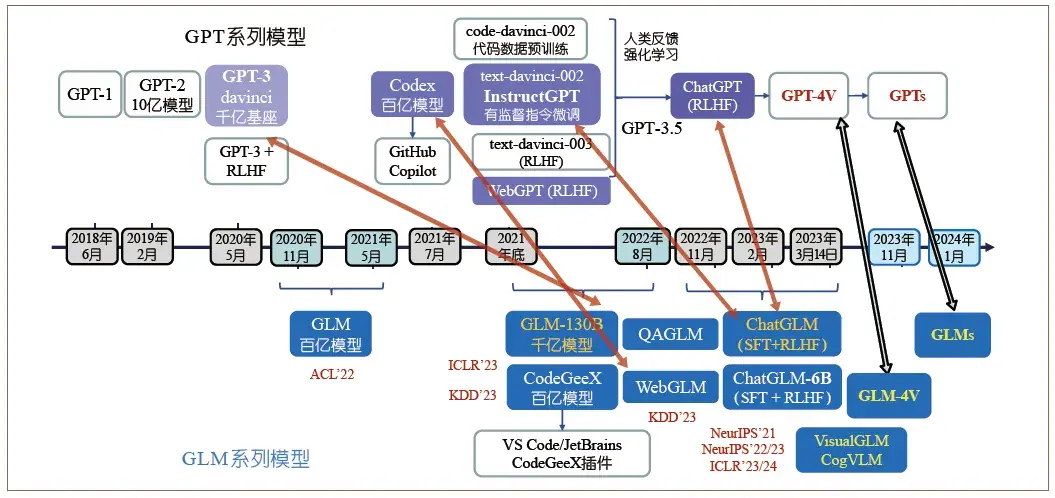
- 图1 GPT系列模型与GLM系列模型对比*
2.1 GLM基础能力
我们对GPT-4和GLM-4在若干数据集上进行了全面的测试分析。表1列出了在国际通用英文数据集上的评测结果。第一个数据集MMLU是大规模多任务语言理解的基准,主要评估模型的零样本(zero-shot)和少样本(few-shot)学习能力。该基准涵盖STEM(科学、技术、工程、数学)、人文科学、社会科学等57个科目。它的难度从初级到高级专业水平不等,考验模型掌握世界知识和解决问题的能力。科目范围涵盖从传统领域(如数学和历史)到更专业的领域(如法律和道德)。GSM8K是一个由8500个高质量的语言多样化的小学数学问题组成的数据集,这些问题都是由人类写手创造的。MATH数据集则包含初等代数、代数、数论、计数和概率、几何、中等代数和微积分等领域的多种数学问题,是用LaTeX写的,也就是说并不全是自然语言,而有点像代码阅读。BBH是谷歌推出的一个面向推理的基准测试套件,涵盖了各种AI复杂任务,可以评估语言模型在各种复杂任务上的性能。HellaSwag是一个用于评估自然语言处理模型在常识推理方面表现的基准测试集,由OpenAI团队开发,旨在测试模型解决具有误导性的场景推理问题的能力。它包含70000个多项选择问题,每个问题都涉及两个具体领域的场景。这些问题伪装成可能令人产生错觉的正确答案,目的是测试模型的常识推理能力。在这些数据集上,总体来说GLM-4接近GPT-4。
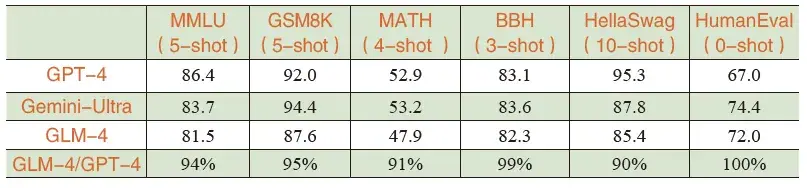
表1 基础能力评测(英文)
2.2 GLM中文对齐能力
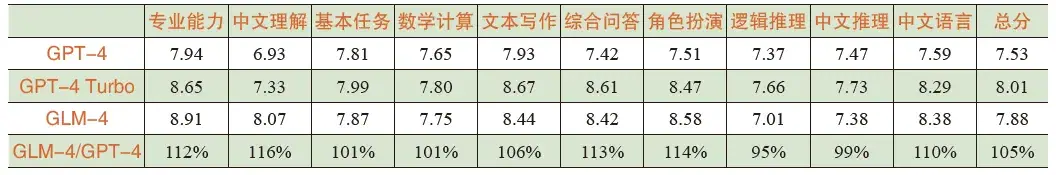
在模型实际应用过程中,我们更注重中文的对齐能力。表2列出了GLM和GPT在中文对齐能力方面的评测对比。数据集使用的是AlignBench。在AlignBench上,GLM-4甚至超过了在2023年6月13日发布的GPT-4,逼近GPT-4 Turbo(GPT-4最新版本,2023年11月6日发布)的效果,尤其是在专业能力、中文理解、角色扮演方面甚至超过GPT-4 Turbo的精度,但在中文推理方面的能力还有待进一步提升。
表2 对齐能力(中文,数据集:AlignBench)