
观点 · 大模型与超级智能· 第 3 / 5 页
2.3 GLM长文本能力
GLM-4支持更长上下文窗口能力(128 K),表3对比了GLM-4和国际上效果最好的几个模型,包括OpenAI的GPT-4和Anthropic的Claude2.1。可以看出GLM-4的效果超过了GPT-4和Claude 2.1,接近GPT-4 Turbo。在大海捞针(Needle Test)测试中,在128 K文本长度内,GLM-4模型均可做到几乎百分之百的召回精度(见图2),基本解决了长上下文全局信息因为失焦而导致的精度下降问题。也就是说,单次提示词可以处理的文本可以达到300页,开发者再也不用担心文档太长而无法一次性处理完了。最重要的是,这个技术可以比较容易地扩展到1 M甚至无限长上下文,例如谷歌最近推出的无限长上下文Transformer。
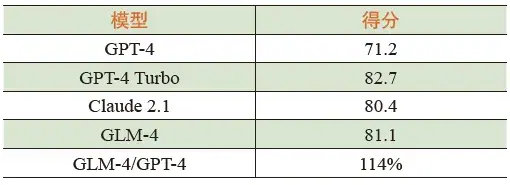
表3 长上下文能力评测(中文,数据集:LongBench、Needle Test)
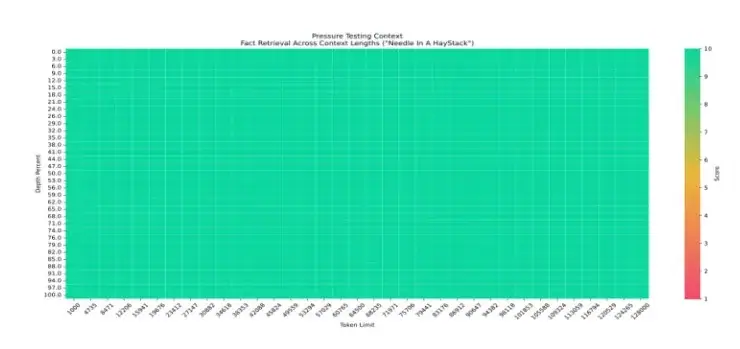
- 图2 Needle Test (128 K),全绿表示100%召回精度*
2.4 GLM多模态能力
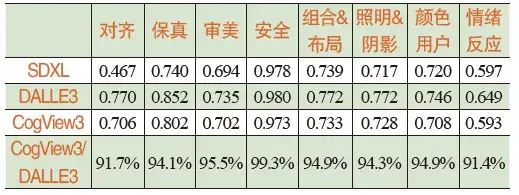
GLM-4内嵌了CogView3。CogView是我们从2021年开始研发的文生图系列模型,目前已经推出CogView、CogView2和CogView3三个版本,几乎是和DALL·E的系列模型同期推出。表4列出了CogView3和SDXL、DALL·E3的对比情况。可以看出,在各项指标上,CogView3都明显超过开源最佳的SDXL,与OpenAI最新发布的DALL·E3相当,在对齐、保真、安全、组合&布局等各个评测维度上,CogView3的效果能达到DALL·E3的90%以上。
表4 文生图性能评测(SDXL是开源最佳模型)
2.5 GLM智能体能力
GLM-4还有一个全新的功能——All Tools。传统的大模型系统只能用大模型的某一个功能,或者使用提示词激活某个方面的能力。All Tools基于GLM模型的智能体能力,实现根据用户意图,自动理解、规划复杂指令,自由调用网页浏览器、代码解释器(code interpreter)和多模态文生图大模型,以完成复杂任务。类似于OpenAI近期推出的GPTs的基础能力,只需一个指令,GLM-4就会自动分析指令,结合上下文选择要调用的合适工具。表5给出了GLM-4和GPT-4的All Tools性能对比:通过自动调用Python解释器进行复杂计算(复杂方程、微积分等),在GSM8K、MATH、Math23K三个数据集上,GLM-4均能取得与GPT-4相当的效果。其中Math23K是一个用于研究机器自动解数学应用题的数据集,包含23162道小学数学应用题及其解题公式,可被用来检验大模型对数字的理解能力。
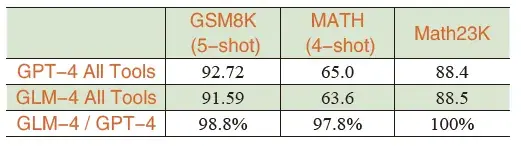
表5 GLM-4和GPT-4的All Tools对比:代码解释器
表6给出了GLM-4和GPT-4在网页自动浏览以及函数自动调用方面的性能对比。网页自动浏览是指模型自行规划检索任务、自行选择信息源并自动与信息源进行交互。函数调用是根据用户提供的函数描述,模型自动选择所需函数并生成参数,以及根据函数的返回值生成回复。GLM-4支持针对一次输入进行多次函数调用,并支持包含中文及特殊符号的函数名字。
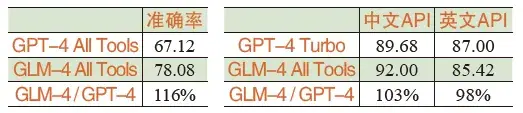
表6 GLM-4和GPT-4的All Tools对比:网页浏览(左)和函数调用(右)
图3展示了一个例子,问题是“查询一下全球近年的GDP。分析这些数据中哪些年份GDP下降了,画折线图并将下降的年份标红”。可以看到GLM-4首先自行决定调用搜索,从网页中找到全球GDP数据,然后选择编写程序实现GDP数据的曲线统计,通过解读“对下降年份标红”,在程序中设置了两种不同的标记方式并画出曲线图,最后给出了对曲线图的解读。可以看出GLM-4已经实现了自动将多个工具无缝整合使用。
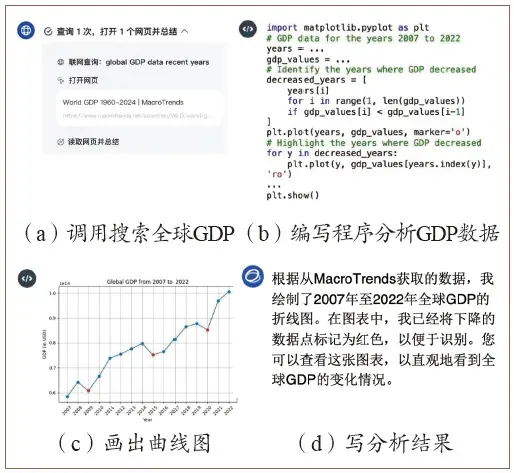
图3 GLM-4 All Tools案例:“查询一下全球近年的GDP。分析这些数据中哪些年份GDP下降了,画折线图并将下降的年份标红”
在智能体能力和All Tools工具的支持下,GLM-4实现了GLMs模型应用商店。截至2024年4月20日,已经有20多万应用在GLMs登陆。访问量最高的智能体应用每天支持数万用户访问。GLM-4智能体使任何人都能够运用GLM-4模型并挖掘它的潜力,没有任何编程基础也能够实现大模型应用的开发。
三、关于AGI的一点思考
当前AGI的研究还面临很多挑战,很多基础理论问题尚未得到根本解决,包括:
- 未来AGI之路在哪里?是多模态预训练模型还是用大模型实现智能的操作系统?
- 如何实现超级对齐?从更理论的角度,也许AGI也需要参考人脑智能的实现机理。
- 如何实现更高效的训练,摆脱现在依赖英伟达的GPU路线?能否统一芯片和模型算法,实现更加高效的模型训练?
笔者团队针对以上三个挑战,围绕超级智能和超级对齐,融合软件和硬件展开相关AGI研究。